背景: 歯周炎は、複数の臨床的および放射線写真的要因によって示されるように、最も蔓延しているが予防可能な口腔疾患の 1 つです。これらの要因は電子医療記録 (EHR) に記録されるため、その再利用により個別のリスク評価と対象を絞った予防の機会が提供されます。予測 AI と従来の機械学習モデルは、断片化された検出タスクをサポートしますが、テキスト予測と画像予測の統合が不足しています。新しいマルチモーダル大規模言語モデル (M-LLM) は、臨床評価のためにこれらのデータ ソースを組み合わせることが期待されています。したがって、M-LLM の機能を評価し、現在の臨床標準と比較することは、デジタル アシスタントとしての可能性を判断するために不可欠です。 目的: この研究は、EHR データと X 線所見に基づいて、M-LLM が歯周炎のリスクを評価し、予防戦略を提案する能力を評価することを目的としました。各 M-LLM は歯周病の専門家によって個別に評価され、他のモデルと比較してベンチマークが行われ、基準として歯周病専門医と比較されました。 方法:LLM の評価のための TRIPOD (個人の予後または診断のための多変数予測モデルの透明性報告) ガイドラインに従ってビネット研究を実施しました。10 個の歯周ビネットが作成され、それぞれにパノラマ X 線写真とテキストの EHR データが含まれています。マルチモーダル データを推論して処理できる 3 つの LLM を、同じプロンプトと入力データに基づいて手動で出力を生成する歯周病専門医と比較しました。歯周病の専門家は、事前に定義された 6 つの基準にわたってすべての成果を 5 段階のリッカートスケールで評価しました。統計分析では、モデルごとの全体的なパフォーマンスを評価し、モデル、シナリオの複雑さ、または評価者ごとにパフォーマンスが異なるかどうかをテストしました。 結果: GPT o1 Pro と Claude Sonnet 4 は高いパフォーマンスを示し、評価の 86.7% と 85.6% が許容できると判断し、歯周病専門医の成果 (87.8%) に匹敵しました。Gemini 2.5 Pro は、歯周病専門医と他のモデルの両方よりも大幅に低いと評価されました (59.4% 許容可能、P<.002)。X 線読影は、すべてのモデルおよび歯周病専門医の他の能力よりも一貫して低いスコアを獲得しており、Gemini は許容しきい値を下回っていました。完了までに必要な時間は、クロードの場合は約 10 秒、ジェミニの場合は 37 秒でした。GPT の場合は 3 分 22 秒。歯周病専門医は5分57秒。 結論: M-LLM は歯周評価において強力な推論能力を示しました。すべてのモデルにわたって、許容できない要素は一貫して X 線読影のエラーに関連していましたが、プロンプトの改良や新しいモデルのバージョンではこれが改善される可能性があります。特に、X線検査所見が不正確でプラーク保持因子が存在しない場合でも、出力は依然として良好に評価されており、EHRデータのみが実質的な根拠を提供していることを示しています。臨床応用のためには、M-LLM は少なくとも歯周病専門医と同等のパフォーマンスを発揮し、歯周病の専門家によって設定された品質基準を満たさなければなりません。GPT と Claude がこの基準に近づいているようです。
背景: 歯周炎は、複数の臨床的および放射線写真的要因によって示されるように、最も蔓延しているが予防可能な口腔疾患の 1 つです。これらの要因は電子医療記録 (EHR) に記録されるため、その再利用により個別のリスク評価と対象を絞った予防の機会が提供されます。予測 AI と従来の機械学習モデルは、断片化された検出タスクをサポートしますが、テキスト予測と画像予測の統合が不足しています。新しいマルチモーダル大規模言語モデル (M-LLM) は、臨床評価のためにこれらのデータ ソースを組み合わせることが期待されています。したがって、M-LLM の機能を評価し、現在の臨床標準と比較することは、デジタル アシスタントとしての可能性を判断するために不可欠です。 目的: この研究は、EHR データと X 線所見に基づいて、M-LLM が歯周炎のリスクを評価し、予防戦略を提案する能力を評価することを目的としました。各 M-LLM は歯周病の専門家によって個別に評価され、他のモデルと比較してベンチマークが行われ、基準として歯周病専門医と比較されました。 方法:LLM の評価のための TRIPOD (個人の予後または診断のための多変数予測モデルの透明性報告) ガイドラインに従ってビネット研究を実施しました。10 個の歯周ビネットが作成され、それぞれにパノラマ X 線写真とテキストの EHR データが含まれています。マルチモーダル データを推論して処理できる 3 つの LLM を、同じプロンプトと入力データに基づいて手動で出力を生成する歯周病専門医と比較しました。歯周病の専門家は、事前に定義された 6 つの基準にわたってすべての成果を 5 段階のリッカートスケールで評価しました。統計分析では、モデルごとの全体的なパフォーマンスを評価し、モデル、シナリオの複雑さ、または評価者ごとにパフォーマンスが異なるかどうかをテストしました。 結果: GPT o1 Pro と Claude Sonnet 4 は高いパフォーマンスを示し、評価の 86.7% と 85.6% が許容できると判断し、歯周病専門医の成果 (87.8%) に匹敵しました。Gemini 2.5 Pro は、歯周病専門医と他のモデルの両方よりも大幅に低いと評価されました (59.4% 許容可能、P<.002)。X 線読影は、すべてのモデルおよび歯周病専門医の他の能力よりも一貫して低いスコアを獲得しており、Gemini は許容しきい値を下回っていました。完了までに必要な時間は、クロードの場合は約 10 秒、ジェミニの場合は 37 秒でした。GPT の場合は 3 分 22 秒。歯周病専門医は5分57秒。 結論: M-LLM は歯周評価において強力な推論能力を示しました。すべてのモデルにわたって、許容できない要素は一貫して X 線読影のエラーに関連していましたが、プロンプトの改良や新しいモデルのバージョンではこれが改善される可能性があります。特に、X線検査所見が不正確でプラーク保持因子が存在しない場合でも、出力は依然として良好に評価されており、EHRデータのみが実質的な根拠を提供していることを示しています。臨床応用のためには、M-LLM は少なくとも歯周病専門医と同等のパフォーマンスを発揮し、歯周病の専門家によって設定された品質基準を満たさなければなりません。GPT と Claude がこの基準に近づいているようです。
BACKGROUND: Periodontitis is one of the most prevalent yet preventable oral diseases, as indicated by multiple clinical and radiographic factors. As these factors are recorded in electronic health records (EHRs), their reuse offers opportunities for personalized risk assessment and targeted prevention. Predictive AI and traditional machine learning models support fragmented detection tasks but lack the integration of textual and imaging predictors. Emerging multimodal large language models (M-LLMs) show promise in combining these data sources for clinical assessment. Evaluating the capabilities of M-LLMs and comparing them against the current clinical standard are therefore essential to determine their potential as digital assistants. OBJECTIVE: This study aimed to evaluate the ability of M-LLMs to assess periodontitis risk and suggest prevention strategies, based on EHR data and radiographic findings. Each M-LLM was individually evaluated by periodontal experts, benchmarked against other models, and compared with a periodontist as a reference. METHODS: A vignette study was conducted following TRIPOD (Transparent Reporting of a Multivariable Prediction Model for Individual Prognosis or Diagnosis) guidelines for the evaluation of LLMs. Ten periodontal vignettes were created, each including a panoramic radiograph and textual EHR data. Three LLMs capable of reasoning and handling multimodal data were compared to a periodontist who generated outputs manually, based on the same prompts and input data. Periodontal experts rated all outputs across 6 predefined criteria on a 5-point Likert scale. Statistical analyses evaluated overall performance per model and tested whether performance varied per model, scenario complexity, or rater. RESULTS: GPT o1 Pro and Claude Sonnet 4 showed strong performance, with 86.7% and 85.6% of ratings deemed acceptable-comparable to the periodontist's output (87.8%). Gemini 2.5 Pro was rated significantly lower than both the periodontist and the other models (59.4% acceptable; P<.002). Radiographic interpretation consistently received lower scores than other abilities across all models and the periodontist, with Gemini rated below the acceptable threshold. The time required for completion ranged from approximately 10 seconds for Claude to 37 seconds for Gemini; 3 minutes, 22 seconds, for GPT; and 5 minutes, 57 seconds, for the periodontist. CONCLUSIONS: M-LLMs demonstrated strong reasoning abilities in periodontal assessment. Across all models, unacceptable elements were consistently related to errors in radiographic interpretation, though refined prompting or newer model versions may improve this. Notably, even when radiographic findings were incorrect and plaque-retentive factors were absent, outputs were still rated well, indicating that EHR data alone provide a substantial basis. For clinical applicability, M-LLMs must at least perform comparably to a periodontist and meet the quality standards set by periodontal experts-a bar that GPT and Claude appear to approach.
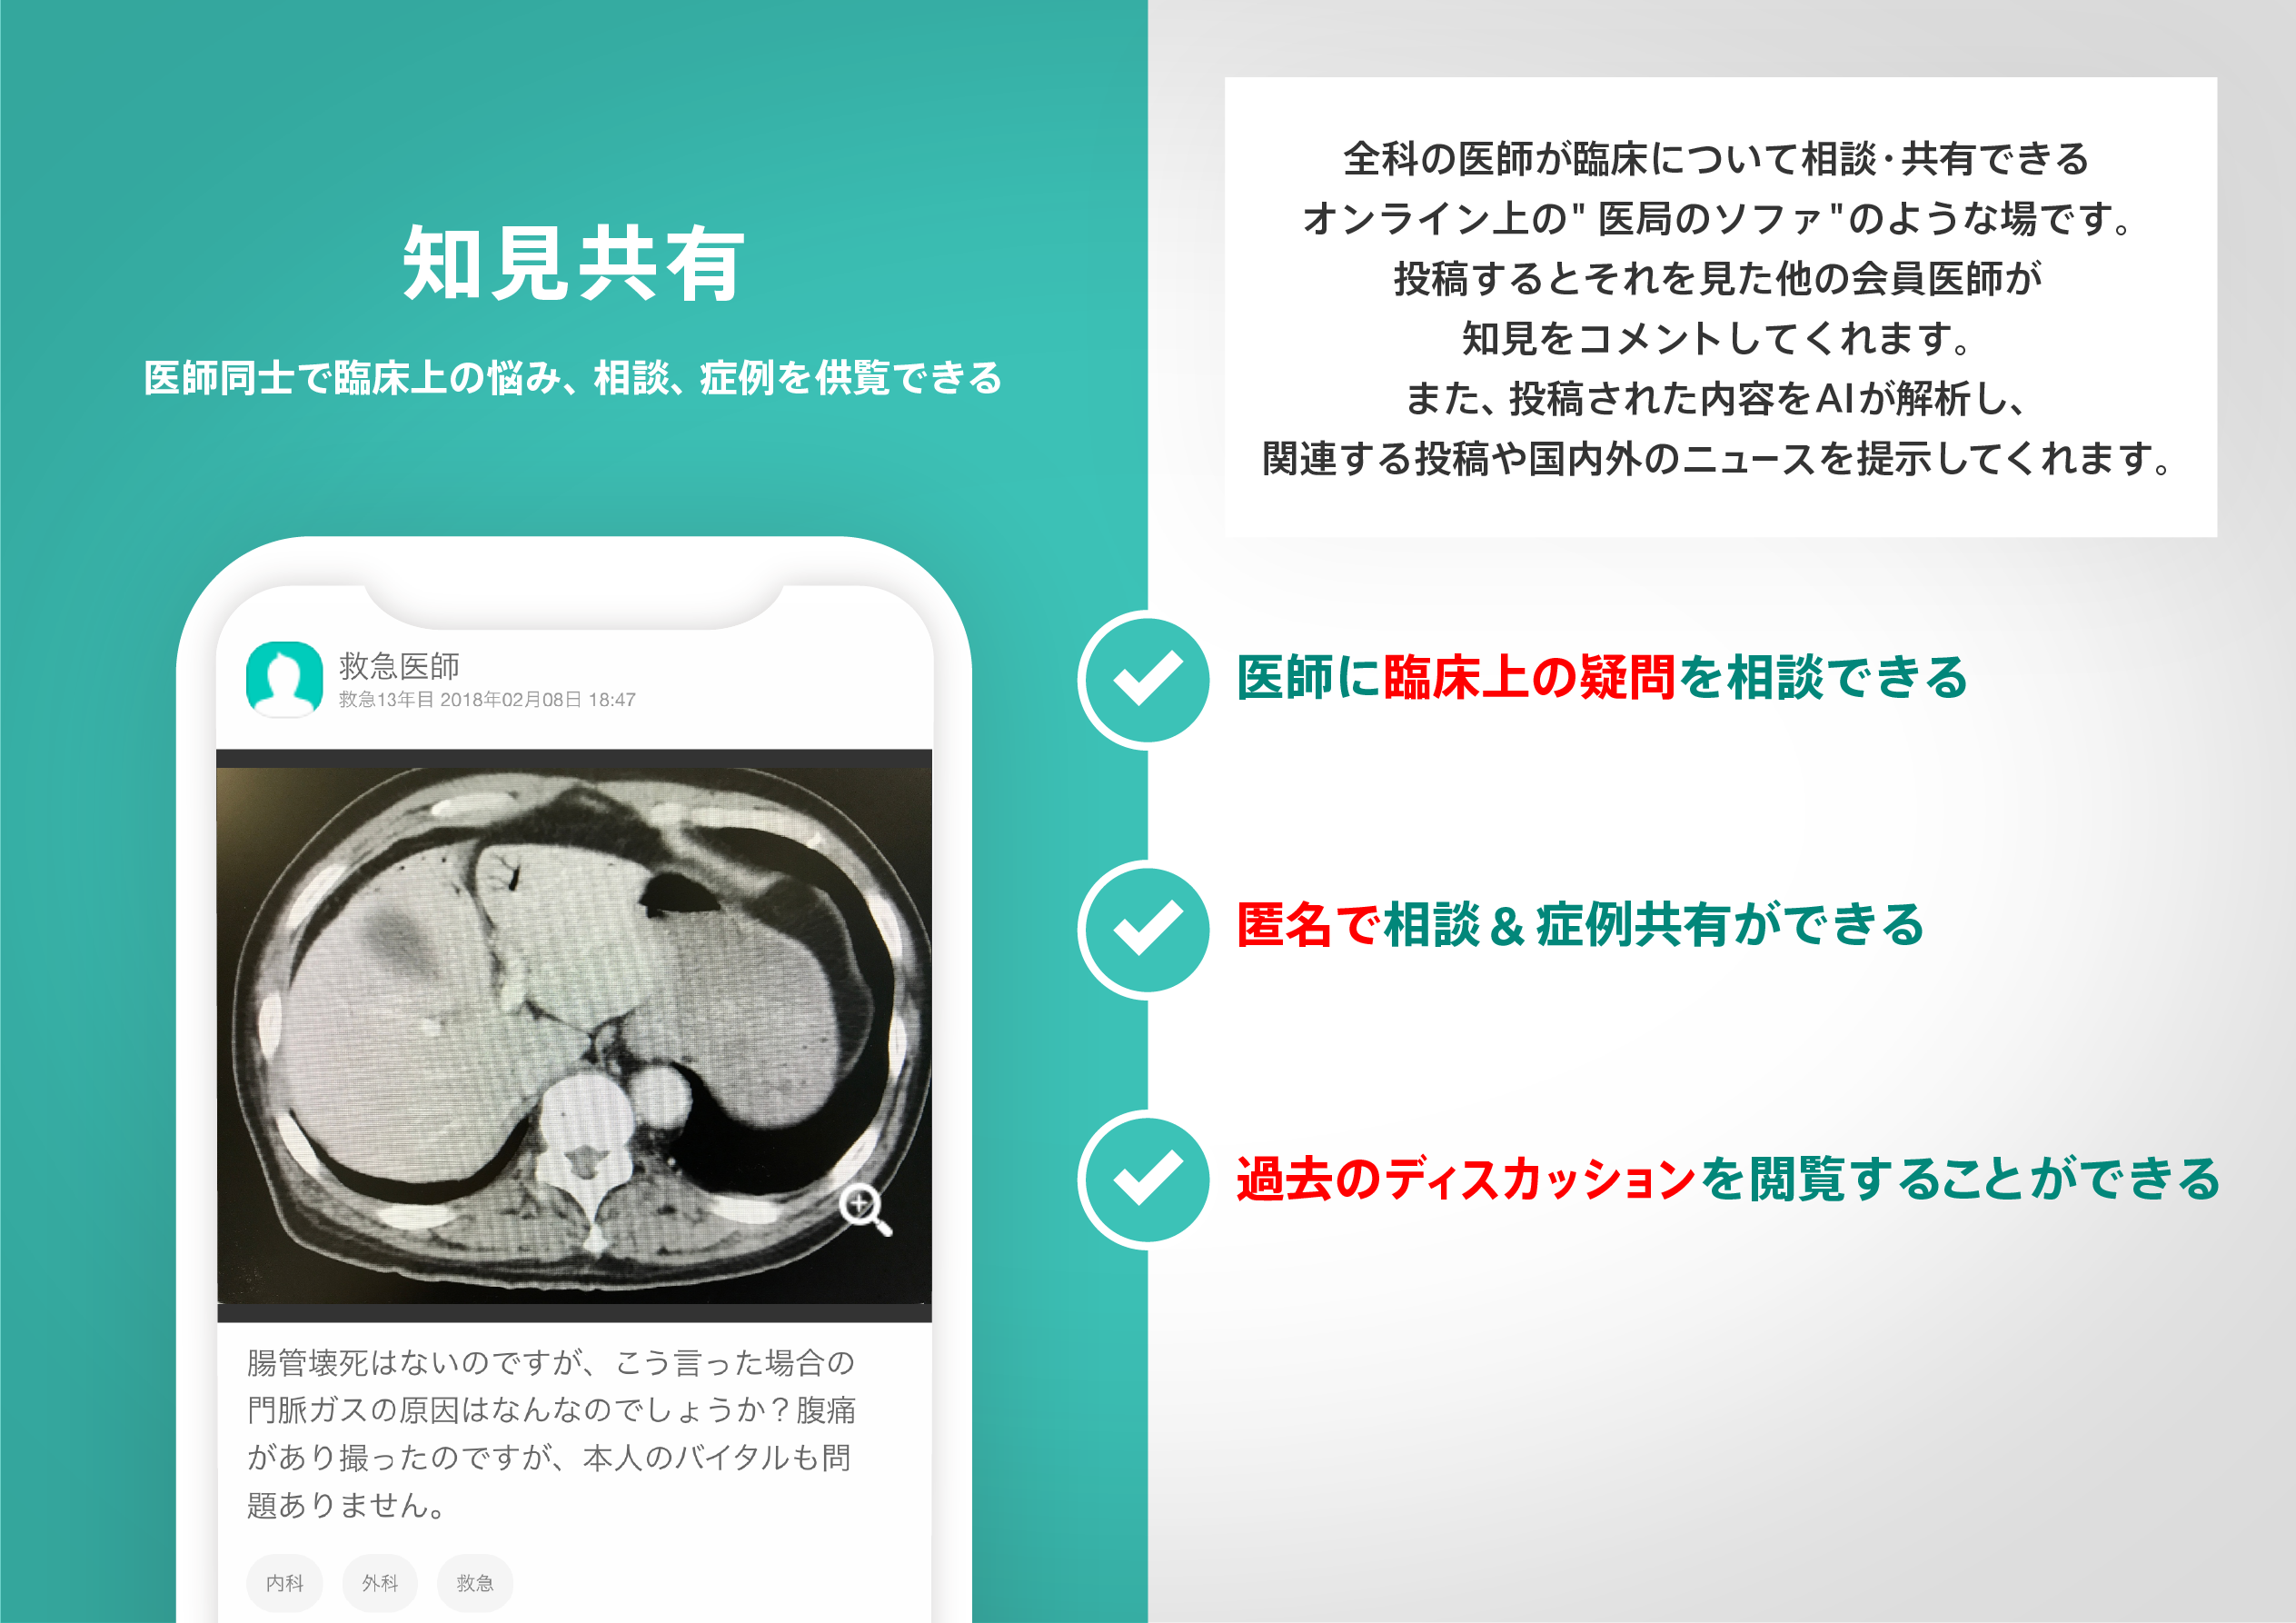
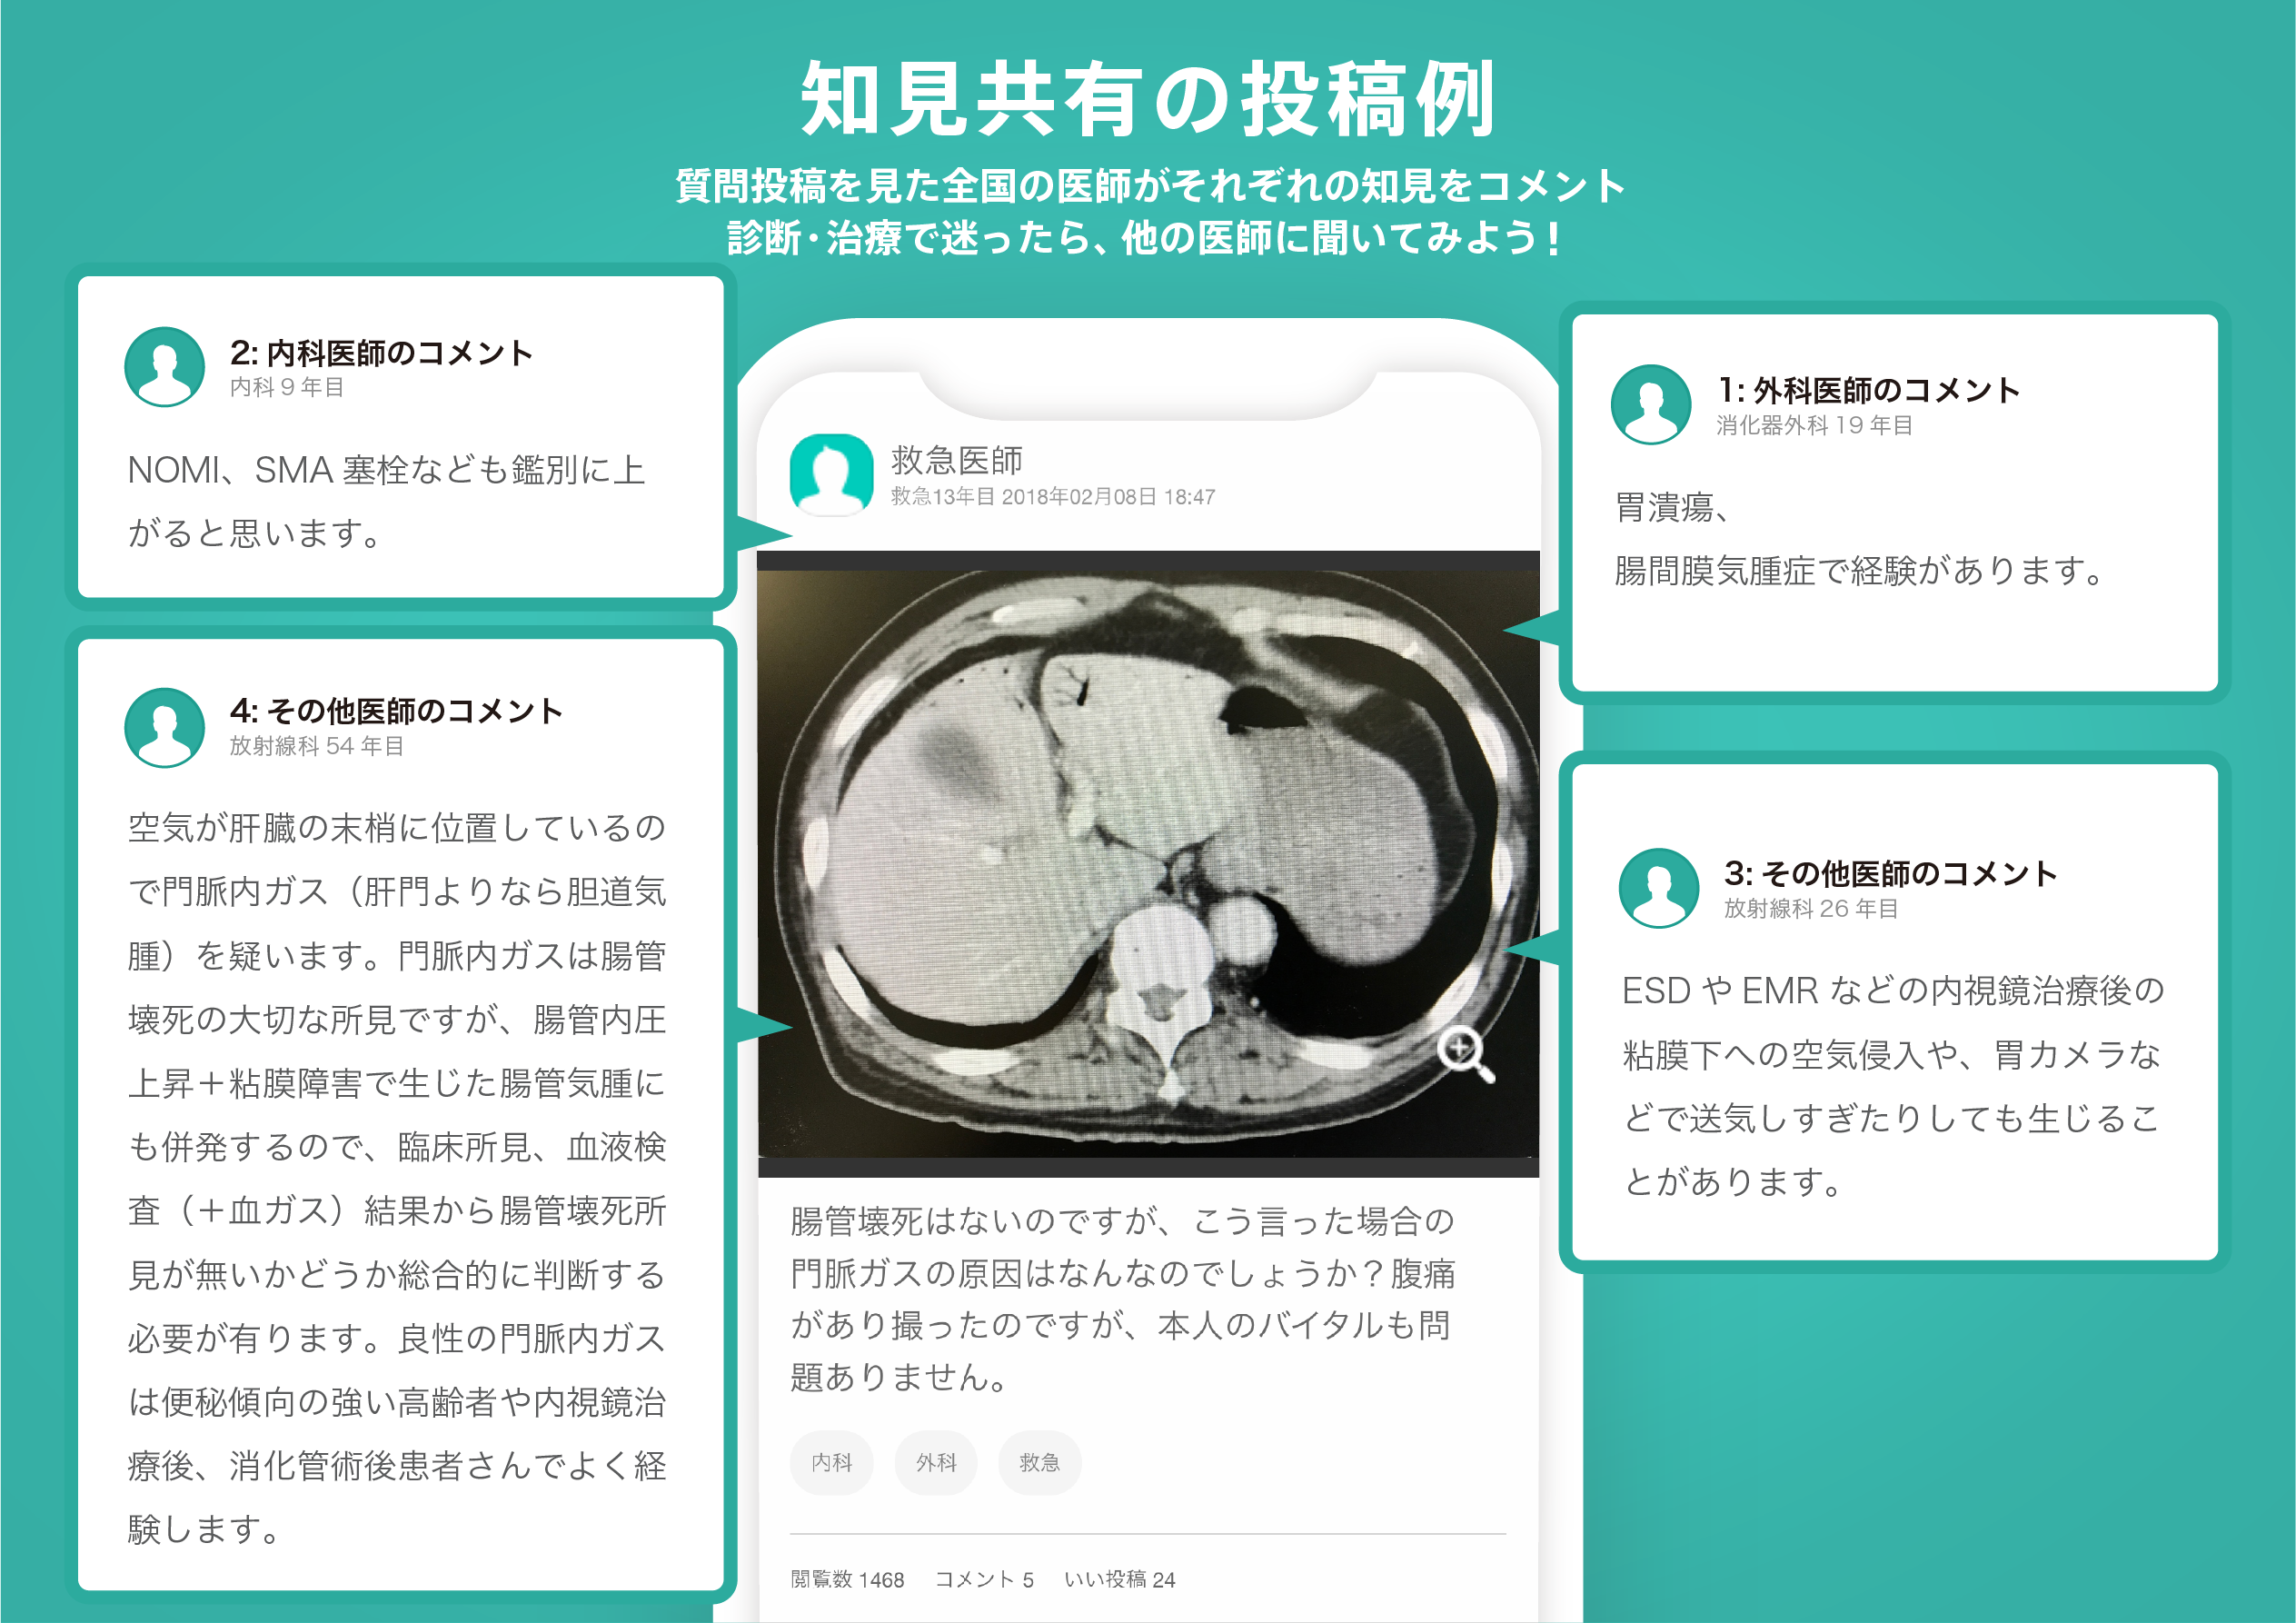
医師のための臨床サポートサービス
ヒポクラ x マイナビのご紹介
無料会員登録していただくと、さらに便利で効率的な検索が可能になります。